
はじめに
スマホやパソコンで文章を打つとき、画面の文字がどうやって表示されているのか、考えたことはありますか。
実はコンピュータの中には、文字の形そのものは入っていません。
入っているのは、ゼロと一でできた数字の並びだけなんです。
そこで登場するのが「文字コード」です。
文字に番号をつけて、番号と文字の対応表を決めておくしくみのことですね。
この表がそろっていないと、画面に意味のわからない記号が並ぶ「文字化け」が起きてしまいます。
この記事では、中学技術の情報分野で習う文字のデジタル化を、例題つきで順番に整理していきますよ。
定期テスト前の確認にも、ぜひ使ってくださいね。
動画で話した内容を土台に、読んで確かめられるように、ひとつずつ丁寧に書き足しました。
わからない用語が出てきたら、その見出しに戻って読み直してみてください。
- 文字コードとは何か:文字を番号に置きかえる対応表の意味と、符号化という言葉がわかります。
- ASCIIと日本語の文字コード:英数字の表と、日本語に2バイトが必要な理由がつながります。
- 文字化けの原因と対策:なぜ起きるのか、どう防ぐのかを例題つきで確かめられます。
文字コードと文字化けの全体像
今回の内容は、「文字を数に置きかえる」という一本の線でつながっています。
まず文字コードという対応表があり、次に英数字と日本語で表の大きさが違うことを学びます。
最後に、書く側と読む側で表がずれたときに起きる現象として、文字化けを整理します。
この順番で読めば、用語がばらばらにならず、一つの流れとして頭に入りますよ。
- ポイント1:文字コードは、文字と番号を結びつけた対応表です。
- ポイント2:ASCIIは英数字、日本語は2バイトが基本で、世界共通の表がUnicodeです。
- ポイント3:文字化けは、書く側と読む側で表が違うと起きます。
ポイント1:文字コードは「文字と番号の対応表」
最初のポイントは、コンピュータが文字をどう扱っているかです。
コンピュータは文字をそのまま持てないので、文字を数に置きかえて記録しています。
この置きかえのルールが文字コードです。
文字コードのしくみのポイントを紹介します
コンピュータが文字をそのまま持てない理由
コンピュータの中身は、電気が流れているかいないかという、二つの状態でできています。
この二つをゼロと一で表すので、扱えるのはゼロと一の並び、つまり数だけなんです。
ひらがなの「あ」やアルファベットの「A」のような文字の形は、そのままでは記録できません。
だから、文字を何かの数に置きかえて、数として保存するという考え方が必要になります。
たとえば「あ」が1番、「い」が2番、というようにあらかじめ決めておけば、数で文字を表せますよね。
この置きかえこそが、文字のデジタル化の出発点なんですよ。
身のまわりにも、似た工夫がありますよね。
たとえばモールス信号は、短い音と長い音の組み合わせで文字を伝えます。
コンピュータの場合は、その二種類の合図がゼロと一で、文字ごとに決まった並びを割り当てているイメージです。
テストで「コンピュータは文字をどのように扱うか」と聞かれたら、「文字を数に置きかえて扱う」と答えられるようにしておきましょう。
文字コードは出席番号のようなもの
文字一つひとつに番号をつけて、番号と文字を結びつけた対応表にしたものが、文字コードです。
出席番号を思い浮かべてみてください。
出席番号を見れば、名簿の表から誰のことかがわかりますよね。
それと同じで、文字コードの番号を見れば、対応表から文字がわかります。
ですから、番号と文字の組み合わせを一覧にした表こそが、文字コードの正体だと考えてください。
表の一行一行が、一つの文字に対応しているイメージですよ。
また、文字を番号やゼロと一の並びに変えることを、符号化(ふごうか)と呼びます。
文字コードと符号化はセットで覚えておくと安心です。
ここで大切なのは、表が決まっていないと意味がないということです。
出席番号も、クラスが変われば同じ番号が別の人を指しますよね。
文字コードも同じで、どの表を使うかをそろえておかないと、あとで説明する文字化けにつながります。
ですから、文字コードは「番号」だけでなく、「どの表の番号か」までがセットだと考えると、理解しやすくなりますよ。
文字の入力から表示までの流れと2進数
キーボードで文字を打つと、その文字は文字コードの番号に変換されて、メモリに記録されます。
画面に表示するときは、同じ対応表を使って、番号を文字の形に戻しているんです。
この流れは、メールを送るときも、文書を作るときも、まったく同じです。
目には見えませんが、画面の裏側で、変換が何度もくり返されているんですよ。
記録されるときの番号は、実際には2進数、つまりゼロと一の並びです。
たとえば大文字のAは、10進数で65番、2進数にすると1000001になります。
入力、保存、表示のどの段階でも、文字は数として扱われていると覚えておきましょう。
ここで例題です。
大文字のAが65番、Bが66番、Cが67番のとき、Dは何番でしょうか。
アルファベット順に1ずつ増えているので、答えは68番になります。
文字コードの番号は、順番に並んでいることが多いので、規則を見つければ計算で求められるんです。
テストでも、このように「となりの文字の番号」を問う形がよく出ますから、1ずつ増減させる考え方を覚えておいてください。
- 数に置きかえる:コンピュータはゼロと一しか扱えないので、文字は番号にして記録します。
- 対応表が文字コード:文字と番号を結びつけた表を使って、保存と表示を行います。
- 記録は2進数:Aは65番で、2進数にすると1000001です。
ポイント2:ASCIIコードと日本語の文字コード
次のポイントは、どんな文字を表したいかで、必要な表の大きさが変わるということです。
英数字なら128通り、日本語なら6万通り以上が必要になります。
この違いが、バイト数の違いにつながっていきます。
ASCIIと日本語の文字コードのポイントを紹介します
ASCIIコードは英数字のための7ビットの表
ASCII(アスキー)コードは、英語の文字や数字、記号を表すために作られた、昔からある文字コードです。
使うのは7ビットで、2を7回かけた128通りの文字や記号を区別できます。
数字の0は48番、大文字のAは65番、小文字のaは97番から、順番に並んでいます。
同じアルファベットでも、大文字と小文字は別の番号なので、コンピュータは別の文字として区別しているんですよ。
英語中心の文字なら128通りで足りる、というのがアスキーコードの考え方です。
覚えておくと便利なのは、数字の「5」という文字と、数の5が別物だという点です。
キーボードで打った「5」は、数の5ではなく、53番という文字の番号として記録されています。
数字の文字は48番から始まるので、「5」は48に5を足した53番です。
この違いは、プログラミングで数を計算するときにも出てくるので、頭の片すみに置いておくと役立ちますよ。
日本語は種類が多いので2バイトで表す
日本語は、ひらがなやカタカナに加えて、数千字もの漢字があります。
128通りでは、とても足りませんよね。
そこで日本語では、16ビット、つまり2バイトを使って、6万通り以上の文字を区別できるようにしています。
1バイトは8ビットなので、2バイトなら16ビット分の並びが使えることになります。
この「2バイト」という数字は、あとで容量を計算するときに、何度も使いますよ。
日本語のための文字コードとしては、JISコードやShift_JIS(シフトジス)などが作られてきました。
文字の種類が多い言語ほど、1文字に使うビット数が増えるというのが、ここでのポイントです。
このため、半角の英数字は1文字が1バイト、全角の日本語は1文字が2バイトというのが、中学技術では基本の考え方になります。
半角と全角でデータの量が違うのは、このためなんです。
文書ファイルの容量を見積もるときに、半角と全角を数え分ける理由もここにあります。
全角のほうが多くの容量を使うことを、しっかり頭に入れておきましょう。
世界共通のUnicodeとUTF-8の関係
日本語だけでも複数の文字コードがあると、国や言語ごとに表がばらばらになって、困りますよね。
そこで作られたのが、世界中の文字を一つの表にまとめたUnicode(ユニコード)です。
日本語も、中国語も、絵文字も、同じ表の中に入っています。
Unicodeがあれば、一つの文書の中に、日本語と英語と絵文字が混ざっていても、正しく表示できるんです。
Unicodeの番号を、実際のゼロと一の並びに変える方式の一つが、UTF-8(ユーティーエフエイト)です。
今は、ウェブページやスマホの多くが、この方式を使っているんですよ。
UTF-8では、半角の英数字は1バイトのまま、日本語は主に3バイトで表します。
テストの計算問題では、問題文に「全角は2バイト」と書いてあれば、その条件に従うのがルールです。
方式によってバイト数が変わることがあるので、自分で決めつけず、問題文の条件を先に確かめてくださいね。
同じ文章でも、方式によって容量が少し変わることがある、と知っておくと安心です。
- ASCIIは7ビットで128通り:英数字と記号を表す、昔からある文字コードです。
- 日本語は2バイトが基本:文字の種類が多いので、16ビットで6万通り以上を区別します。
- Unicodeは世界共通:UTF-8は、その番号をバイトの並びにする代表的な方式です。
ポイント3:文字化けの原因と防ぎ方
最後のポイントは、文字コードを学んだからこそわかる、文字化けのしくみです。
文字化けは、データが壊れたのではなく、読む側が別の表で文字に直しているだけです。
原因がわかれば、防ぎ方も見えてきます。
文字化けの原因と防ぎ方のポイントを紹介します
文字化けの正体は表の読み違い
画面に意味のわからない記号が、ずらっと並んでしまった経験はありませんか。
あれが文字化けです。
これは、パソコンが壊れたのではなく、読み方がずれただけの状態だと考えてください。
この違いを知らないと、故障だと思って、あわてて消してしまう人もいるんです。
実は、記録されている番号そのものは、壊れていないことがほとんどなんです。
文字を書いた側が使った対応表と、読む側が使った対応表が違うために、同じ番号が別の文字として表示されてしまうだけなんですよ。
データが消えたわけではないと知っておくと、慌てずに対処できます。
たとえるなら、出席番号の名簿が、別のクラスのものにすり替わっている状態です。
番号は同じ12番でも、名簿が違えば別の人の名前が出てきますよね。
文字化けは、まさにこれと同じことが起きているんです。
テストでは「文字化けが起こる原因を答えなさい」という問題が出やすく、「書いた側と読む側で、文字コードが違うから」と答えるのが基本になります。
文字化けが起きやすい場面
文字化けが起きやすいのは、古いメールや、文字コードの指定がないウェブページ、別のソフトで開いたファイルなどです。
たとえば、UTF-8で保存した文書を、Shift_JISとして読むソフトで開くと、文字が化けてしまいます。
外国のソフトや機器とファイルをやりとりするときも、表の違いが原因で化けることがあります。
最近は、ほとんどの場面で自動的に判定されるので出会う機会は減りましたが、しくみを知っておくと原因を考えやすくなりますよ。
学校のパソコンでも、まれに起こります。
たとえば、授業で配られたファイルを、家のパソコンで開いたときに、一部が読めなくなることがあります。
そのときは「壊れた」と決めつけずに、「文字コードが合っていないのかも」と考えられると、一歩落ち着いて対処できるはずです。
文字化けを防ぐ方法はUTF-8にそろえること
文字化けを防ぐ基本は、書く側と読む側で、同じ文字コードにそろえることです。
特別な知識は、いりません。
保存するときにも、開くときにも、同じ文字コードを意識することが、いちばんの近道です。
今は、UTF-8にそろえておけば、多くの場面で安心して使えます。
ファイルを保存するときに文字コードを選べるソフトなら、UTF-8を選んでおきましょう。
もし化けてしまったら、開くソフトの設定で文字コードを選び直すと、元に戻ることが多いんですよ。
どの方法も、原因は表の違いだとわかっていれば、落ち着いて試せます。
ここで例題です。
半角のABCと、全角の「日本」を保存したとき、全部で何バイトでしょうか。
半角は1文字1バイトなので3バイト、全角は1文字2バイトなので4バイトで、合わせて7バイトです。
計算するときは、半角と全角を分けて数え、最後に合計するとミスが減りますよ。
- 原因は表の違い:書く側と読む側で、文字コードが違うと同じ番号が別の文字になります。
- データは壊れていない:番号はそのままなので、読み方を変えれば直ることが多いです。
- UTF-8にそろえる:保存も表示も同じ文字コードにすると、化けにくくなります。
テスト前の確認リスト
ここまでの内容を、定期テストの前に見直せるように、短い確認項目にまとめました。
一つずつ、自分の言葉で言えるかどうかを確かめながら読んでみてください。
すらすら言えない項目があれば、その項目の見出しに戻って読み直すと、効率よく復習できますよ。
声に出して言ってみると、記憶に残りやすくなるのでおすすめです。
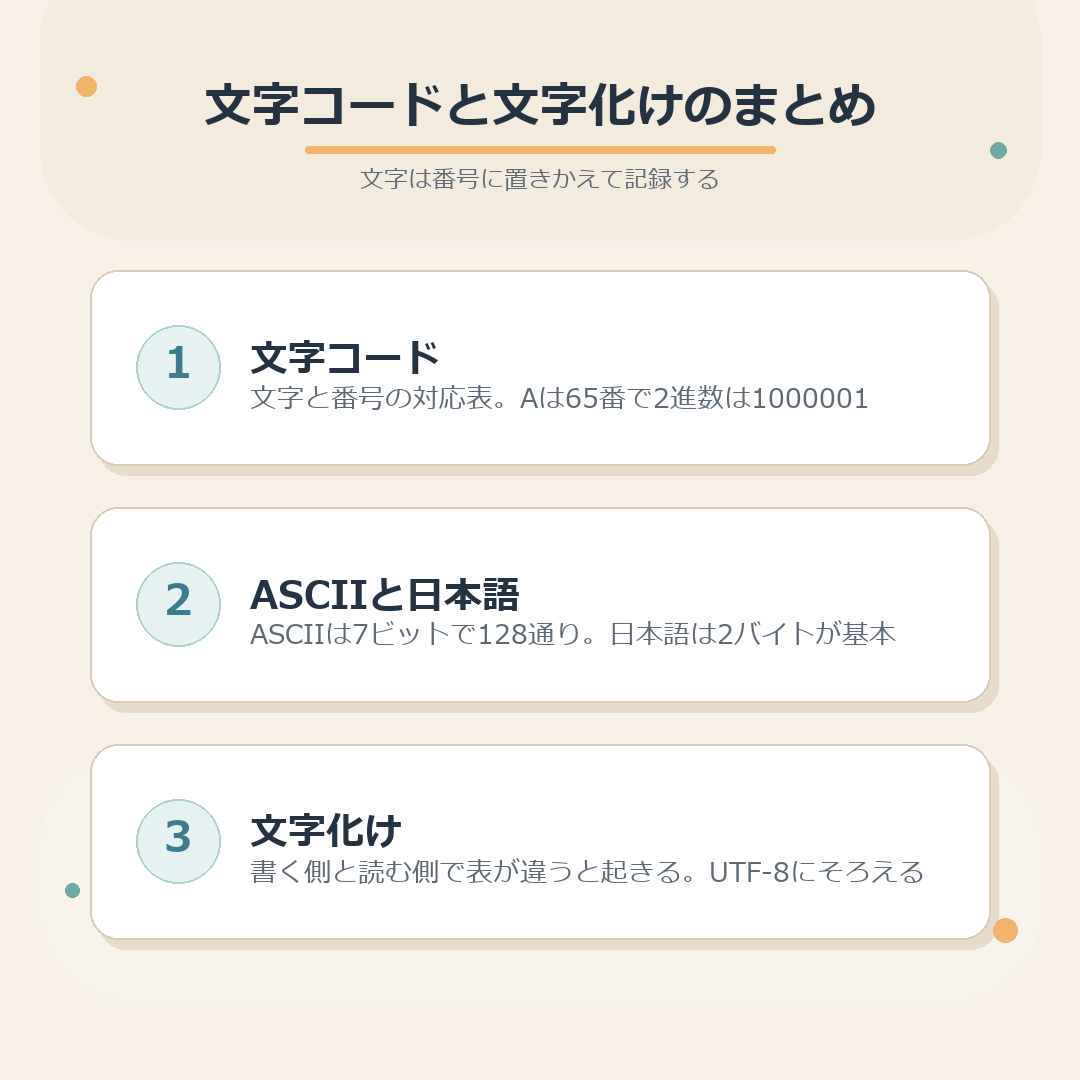
- 文字コードは「文字と番号の対応表」で、文字を番号にすることを符号化という。
- 大文字のAは65番で、2進数にすると1000001になる。
- ASCIIは7ビットで128通りを区別し、英数字と記号を表す。
- 半角の英数字は1バイト、全角の日本語は2バイトが基本である。
- 文字化けの原因は、書く側と読む側で文字コードが違うことである。
よくある質問
テストに出るのは何ですか
結論から言うと、文字コードの意味、文字化けの原因、そして半角と全角のバイト数の計算が、特によく出ます。
文字コードは「文字と番号の対応表」、文字化けは「書く側と読む側で文字コードが違うため」と、短い言葉で答えられるようにしておきましょう。
計算では、半角は1バイト、全角は2バイトという条件を使って、文字数からバイト数を求めます。
学校や教科書によって書き方が少し違うことがあるので、授業ノートの用語もあわせて確認してくださいね。
UnicodeとUTF-8は何が違いますか
結論は、Unicodeが「文字と番号の表」で、UTF-8は「その番号をゼロと一の並びにする方式」です。
つまり、表と、表の使い方の違いと考えるとわかりやすいですよ。
Unicodeには世界中の文字が入っていて、それぞれに番号がついています。
その番号を、実際のバイトの並びに直すルールがUTF-8です。
たとえば、同じUnicodeの文字でも、UTF-8以外の方式で並べることもできます。
ですから、この二つは同じものではないと、区別しておきましょう。
中学の段階では、Unicodeは世界共通の文字コード、UTF-8はその主な方式、と覚えておけば十分です。
文字化けしたらデータは壊れたのですか
結論から言うと、ほとんどの場合、データは壊れていません。
記録された番号はそのままで、読む側が別の表で文字に直しているだけだからです。
ですから、まずは開くソフトの設定で、文字コードを選び直してみましょう。
UTF-8やShift_JISなど、いくつか試すうちに、正しく表示される組み合わせが見つかることが多いです。
ただし、保存の途中で別の文字に置きかえられてしまった場合は、元に戻らないこともあります。
だからこそ、早めに試すことが大切です。
それでも直らないときは、元のファイルを作った人に、文字コードを教えてもらうのが確実ですよ。
おわりに
今回は、文字のデジタル化として、文字コードと文字化けを整理しました。
コンピュータは文字を数に置きかえて扱い、その対応表が文字コードです。
英数字はASCII、日本語は2バイトが基本で、世界共通の表がUnicodeでしたね。
文字化けは、書く側と読む側で表が違うと起きるもので、UTF-8にそろえると防ぎやすくなります。
ここまでを自分の言葉で説明できれば、テストの記述問題にも落ち着いて答えられるはずです。
まずは、確認リストを声に出して読むところから、始めてみてくださいね。
ご視聴ありがとうございました。
この記事の内容を動画でも解説しています。
ぜひご覧ください。
役に立ったと思ったら、チャンネル登録もしてもらえるとうれしいです。